Índice
ToggleLa mayoría de los proyectos biométricos que fracasan se deben a que se ha elegido la operación equivocada, no al proveedor equivocado. La verificación y la identificación parecen similares en un esquema, pero se comportan de forma totalmente diferente cuando se aplican a gran escala.
Acertar en esto desde el principio determina tus objetivos de precisión, el coste de tu infraestructura y si tu sistema podrá crecer sin necesidad de una reconstrucción.
Las dos operaciones
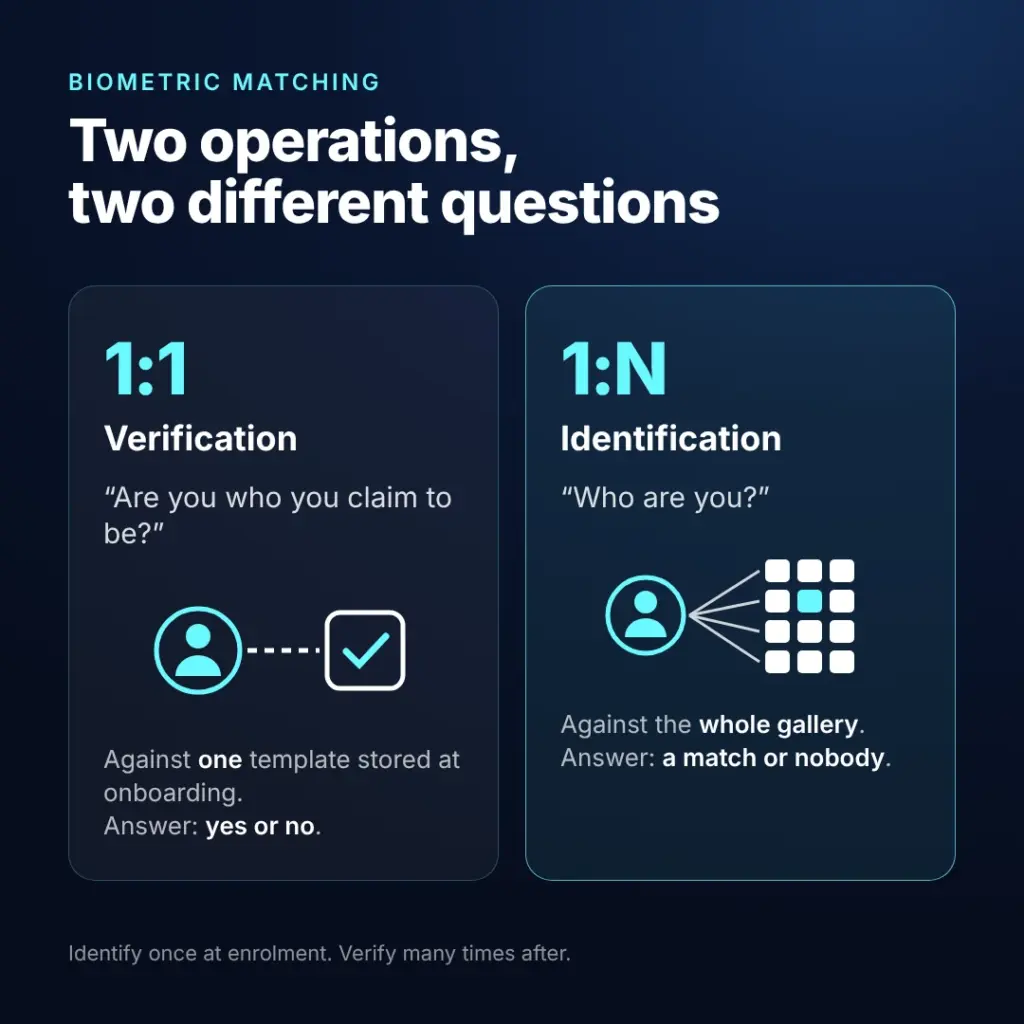
Verificación, 1:1 por escrito. El usuario afirma su identidad, normalmente iniciando sesión en una cuenta o presentando una credencial, y el sistema compara una captura reciente con la plantilla biométrica registrada para esa identidad en el momento de su inscripción inicial. La respuesta es «sí» o «no». El caso más habitual es la verificación de identidad tras un proceso de alta satisfactorio: el cliente registró su rostro durante el proceso de alta y, cada vez que inicia sesión, realiza una transacción de alto valor o solicita la recuperación de su cuenta, se comprueba dicha información con la referencia almacenada.
Identificación, descrita como 1:N. No se formula ninguna afirmación. El sistema compara los datos biométricos con toda la base de datos de personas registradas y devuelve los resultados que coincidan, o ninguno. Encontrar a una persona en un registro nacional, comprobar una lista de vigilancia y eliminar duplicados de un registro son, todos ellos, procesos de identificación.
La norma ISO/IEC 2382-37 define formalmente este vocabulario, por lo que conviene citarla en un documento de licitación cuando los distintos proveedores utilicen los términos de forma imprecisa.
Los deepfakes son cada vez más sofisticados, lo que aumenta el riesgo de fraude y manipulación de la identidad en entornos digitales. Descargue nuestra guía de 10 pasos para aprender a detectar amenazas de forma temprana y proteger su organización con prácticas recomendadas de eficacia probada.
Por qué el problema 1:N es más complicado de lo que parece
En una comparación 1:1, una respuesta incorrecta es una respuesta incorrecta. Las tasas de error relevantes son la tasa de coincidencias falsas y la tasa de no coincidencias falsas.
En una búsqueda 1:N, el sistema realiza una comparación con cada registro registrado. Cada una de esas comparaciones conlleva una pequeña probabilidad de que se produzca una coincidencia errónea. A medida que la base de datos crece, esas pequeñas probabilidades se acumulan y, con ello, aumenta la probabilidad de que algún candidato erróneo ocupe un puesto superior al candidato correcto.
La consecuencia práctica es que un algoritmo con excelentes resultados en la relación 1:1 puede ofrecer un rendimiento deficiente en la relación 1:N con diez millones de registros. Por eso las métricas de error cambian de nombre para la identificación —pasando a denominarse «tasa de falsos positivos en la identificación» y «tasa de falsos negativos en la identificación»— y por eso el NIST evalúa ambos escenarios en programas distintos.
A la hora de comparar proveedores, insiste en que te faciliten cifras de 1:N con una galería de tamaño similar al tuyo. Un resultado de 1:1 no te dice prácticamente nada sobre el rendimiento en la identificación.
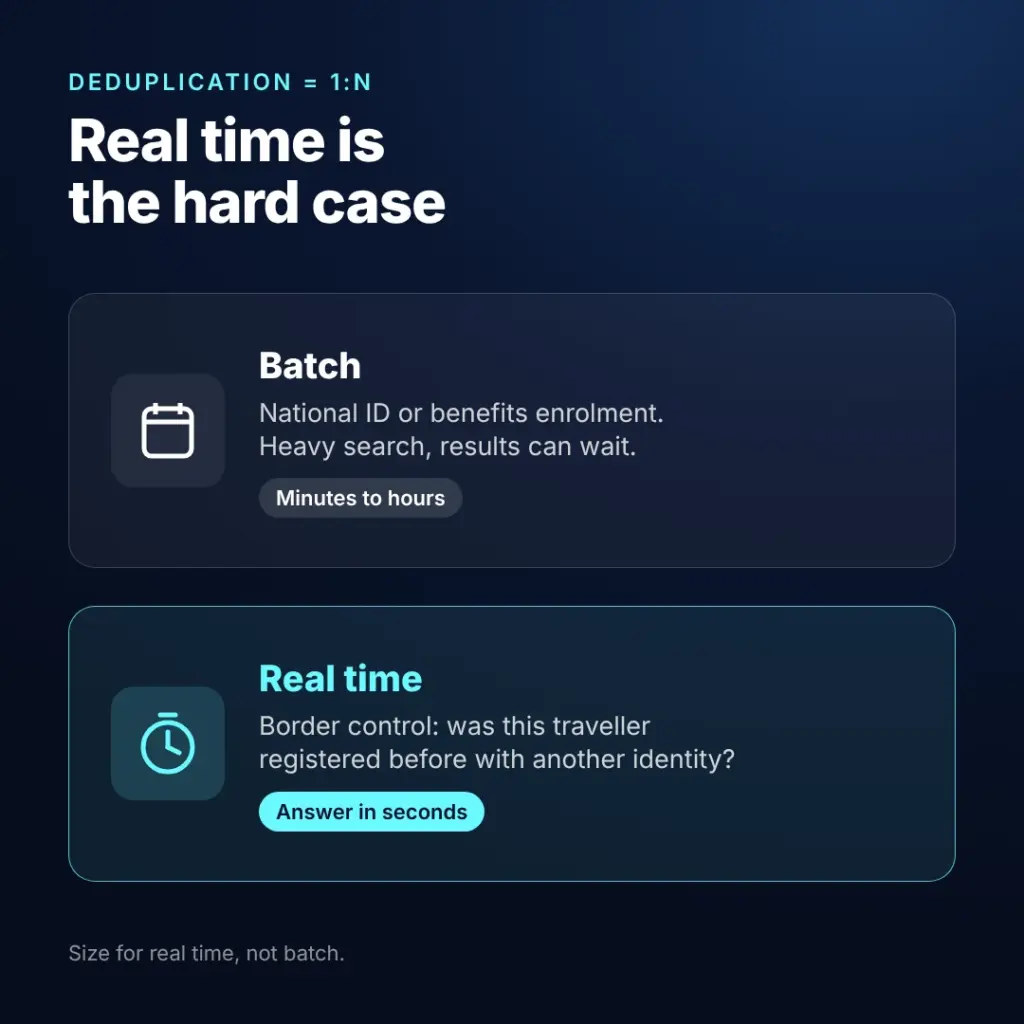
La deduplicación consiste en la identificación, y el tiempo real es el caso más complicado
La deduplicación es una búsqueda de tipo 1:N que comprueba si un sujeto ya figura en el registro con una identidad diferente. Protege la integridad del registro y se presenta en dos formas muy distintas.
La deduplicación por lotes se ejecuta cuando alguien se inscribe en un programa, como el de identificación nacional o un plan de prestaciones. La búsqueda requiere muchos recursos, pero el resultado puede obtenerse en cuestión de minutos u horas, por lo que las tareas pueden ponerse en cola y procesarse cuando la capacidad lo permita.
La dificultad radica en la deduplicación en tiempo real. El control fronterizo es el caso típico: se registra a un viajero en el puesto de control y el sistema tiene que determinar, mientras la persona se encuentra allí, si ya ha sido registrada anteriormente con otra identidad y otro pasaporte. La búsqueda completa en la base de datos, el requisito de precisión y un margen de latencia de segundos se aplican todos a la vez. Los grandes sistemas fronterizos, como el Sistema de Entrada y Salida de la UE, se han diseñado en torno a este requisito.
A continuación se exponen tres decisiones de diseño.
En primer lugar, dimensiona la infraestructura para el caso en tiempo real, no para el procesamiento por lotes. Un motor de coincidencia que gestione sin problemas la deduplicación nocturna puede, aun así, no cumplir el objetivo de respuesta inferior a un segundo en el punto de acceso.
En segundo lugar, aplica la deduplicación en más de una modalidad siempre que sea posible. Los intentos de registro duplicados suelen ser deliberados, y un usuario decidido intentará burlar la modalidad que sabe que se está comprobando. La combinación del reconocimiento facial y de huellas dactilares cubre esa laguna.
En tercer lugar, el «backfill» es importante. Incorporar la deduplicación a un sistema que ya contiene millones de registros implica procesar todo el conjunto histórico de datos a través del motor. Planifícalo como un proyecto, no como un simple cambio.
Dónde se sitúan ambas operaciones en el ciclo de vida completo de una identidad
Un sistema de identidad completo encadena ambas operaciones, en lugar de elegir solo una.
- Captura. Se recopila el dato biométrico y se valida para confirmar que procede de una persona viva. Es aquí donde entra en juego la detección de ataques de presentación, probada según la norma ISO/IEC 30107-3, y donde deben detenerse los ataques de inyección, ya que ninguna decisión de coincidencia posterior puede subsanar una captura comprometida. Identy.io procesa la captura en el propio dispositivo, por lo que el dato biométrico se valida en el mismo lugar en el que se crea.
- Verificar. Comparación 1:1 con un registro declarado. Rápido, económico y para grandes volúmenes.
- Identificar. Una búsqueda 1:N cuando no existe ninguna afirmación o cuando la afirmación debe contrastarse con el conjunto de la población.
- Vincular. Los datos biométricos verificados se vinculan a una credencial o a una cuenta, de modo que la identidad pasa a ser reutilizable.
- Reutilización. Las interacciones posteriores se verifican con las credenciales almacenadas, en lugar de volver a realizar el proceso de identificación. Esto es lo que permite mantener los costes bajo control a gran escala.
Los sistemas que omiten el paso de enlace acaban realizando búsquedas 1:N para transacciones que solo necesitaban una búsqueda 1:1, lo cual resulta costoso y más lento de lo necesario.
Qué preguntar a un proveedor
Qué evaluación, qué envío de los participantes, qué tamaño de galería. Si las figuras 1:N son de una sola modalidad o fusionadas. Qué tiempo de respuesta mantiene el motor para una búsqueda 1:N con el tamaño de tu galería, no solo su rendimiento. Cómo gestiona la deduplicación el relleno retrospectivo. Qué ocurre durante la captura, concretamente frente a la inyección. Si las plantillas utilizan formatos de intercambio que se puedan migrar más adelante.
El sistema ABIS de Identy.io admite tanto la verificación 1:1 como la identificación 1:N a partir de reconocimiento facial y de huellas dactilares, con un motor de deduplicación y márgenes de tolerancia configurables; además, los algoritmos subyacentes participan en las evaluaciones del NIST. La sección «¿Qué es ABIS?» describe la arquitectura, y la página de la plataforma ABIS explica cómo la implementa Identy.io.
Preguntas frecuentes
¿Cuál es la diferencia entre la verificación biométrica y la identificación?
La verificación consiste en una comparación uno a uno. El usuario afirma su identidad, normalmente iniciando sesión en una cuenta tras el proceso de registro, y el sistema compara una captura reciente con la plantilla biométrica registrada para esa identidad en el momento de la inscripción. La respuesta es sí o no.
La identificación es una búsqueda de «uno a muchos». No se formula ninguna afirmación, y el sistema compara los datos biométricos con toda la base de datos de personas registradas para determinar quién es esa persona. La norma ISO/IEC 2382-37 define ambos términos de manera formal.
¿Por qué la identificación 1:N es más difícil que la verificación 1:1?
Una búsqueda 1:N compara los datos biométricos introducidos con todos los registros almacenados, y cada comparación conlleva una pequeña probabilidad de que se produzca una coincidencia errónea. A medida que la base de datos crece, aumenta la probabilidad de que un candidato erróneo ocupe un puesto por encima del correcto.
Por eso, la identificación utiliza sus propios parámetros —las tasas de falsos positivos y falsos negativos— y por eso el NIST la evalúa en programas distintos de los dedicados a la comparación uno a uno.
¿La deduplicación es lo mismo que la identificación?
Sí. La deduplicación es una búsqueda de «uno a muchos» que comprueba si el sujeto ya figura en el registro con otra identidad.
Puede ejecutarse de forma por lotes durante el registro, en cuyo caso el resultado puede esperar, o en tiempo real. El control fronterizo es el caso típico de tiempo real: hay que comprobar si un viajero figura en registros anteriores con otras identidades y pasaportes mientras aún se encuentra en el punto de control. La deduplicación en tiempo real es el caso más exigente, ya que requiere precisión y una respuesta inmediata al mismo tiempo.
¿Debería un sistema utilizar una relación 1:1 o 1:N?
La mayoría de los programas reales utilizan ambos, de forma secuencial. La identificación se lleva a cabo una vez durante la inscripción para confirmar que el sujeto es único. A continuación, la identidad se vincula a una credencial, y en las interacciones posteriores se realiza una verificación uno a uno con respecto a dicha credencial.
Realizar búsquedas 1:N para transacciones que solo requieren una relación 1:1 aumenta el coste y la latencia sin mejorar la fiabilidad.
¿Qué papel desempeñan en todo esto los ataques de presentación?
En el momento de la captura, antes de que se ejecute ninguna de las dos operaciones. La detección de ataques de presentación se comprueba según la norma ISO/IEC 30107-3 y determina si los datos biométricos proceden de una persona viva.
Los ataques por inyección eluden el sensor e introducen un flujo sintético en la aplicación, por lo que también deben detenerse en la capa de captura. Ningún motor de coincidencia puede recuperarse de una captura comprometida.
Referencias
- ISO/IEC 2382-37:2022. Tecnología de la información — Vocabulario — Parte 37: Biometría. https://www.iso.org/standard/73514.html
- ISO/IEC 19795-1. Ensayos y elaboración de informes sobre el rendimiento biométrico — Parte 1: Principios y marco.
NIST. Evaluación de la tecnología de reconocimiento facial (FRTE): Identificación 1:N. https://pages.nist.gov/frvt/html/frvt1N.html - NIST. FRIFTE E1N — Resultados de la identificación de huellas dactilares 1:N. https://fingerprint.nist.gov/frifte/e1n/results/
- NIST. Plantilla de huellas dactilares patentada (PFT) III. https://www.nist.gov/itl/iad/image-group/proprietary-fingerprint-template-pft-iii
- ISO/IEC 30107-3:2023. Detección de ataques de presentación biométrica. Parte 3: Ensayos y elaboración de informes. https://www.iso.org/standard/79520.html
- Garantía de calidad de iBeta. ISO 30107-3: Metodología de ensayo para la detección de ataques de presentación. https://www.ibeta.com/iso-30107-3-presentation-attack-detection-confirmation-letters/
- Departamento de Seguridad Nacional. Biometría. https://www.dhs.gov/biometrics
- Reglamento (UE) 2017/2226 del Parlamento Europeo y del Consejo por el que se establece un Sistema de Entrada y Salida (EES). https://eur-lex.europa.eu/eli/reg/2017/2226/oj